大数据处理系统有哪些 Google的相关系统又有何特点
大数据处理系统是支撑海量数据存储与分析的核心技术,不同场景需搭配对应系统。常见的系统类型包括批处理、实时计算等,各有适用场景与技术特点,下面将详细介绍相关内容。
大数据处理系统的分类与选型建议
批处理系统中,MapReduce是经典模式,采用分而治之思想,将数据处理拆分为Map和Reduce操作,降低并行开发难度,但不支持迭代计算。这类系统适合处理关系简单、易划分的大数据,优先搭配Hadoop生态的Hive、Spark SQL等工具。
实时处理与迭代计算场景,Spark是更优解,它通过RDD实现内存计算,处理速度快,不过成本较高。Flink则支持批流一体与增量迭代计算,Kafka是高性能分布式消息总线,Storm是分布式容错实时计算系统,可满足不同实时需求。
非结构化数据存储适合NoSQL数据库,混合场景可结合Hadoop与Spark,兼顾存储与计算效率。选型时需综合数据规模、处理速度及成本等因素,选择适配的技术组合。
Google的核心大数据处理系统
Google的大数据处理“三驾马车”是GFS、MapReduce和BigTable,其中GFS是底层分布式文件系统,专为海量数据存储设计,与其他系统深度集成,Hadoop的HDFS就是基于GFS论文实现的。
Caffeine索引系统基于Percolator的增量处理技术,取代了旧的MapReduce批处理索引,提升了搜索速度;Colossus则是GFS二代,专为BigTable设计,支撑Caffeine索引的构建。
Google系统的架构分为客户端库、主服务器和Tablet服务器,客户端库屏蔽底层复杂性,主服务器负责元数据管理,Tablet服务器动态处理数据读写,可灵活伸缩。
主流大数据平台介绍
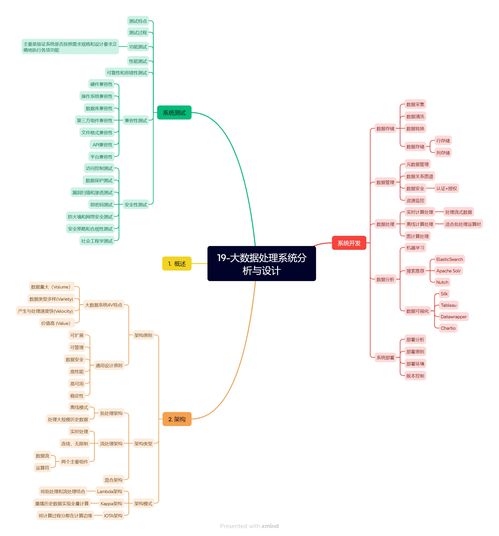
Apache Hadoop是核心框架,包含HDFS和MapReduce,具备高扩展性,生态有Hive、Pig等工具,适合分布式数据处理。批量数据处理系统针对静态海量数据,以批量作业集中处理,应用于金融风控、物联网等场景。
这类系统数据量大、增长稳定,能高效利用计算资源,实现数据分析挖掘,是当前大数据应用的基础支撑。
本站所有文章、数据、图片均来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知我们删除。邮箱:133 46734 45@qq.com
下一篇:没有了